一次拍摄留下几十张相似的照片时,逐张放大检查很费时间。一个自然的想法是先给照片算个“清晰度分数”,把明显失焦或晃动的照片排到后面。不过,这个分数到底在测什么,需要先说清楚。
拉普拉斯和 Sobel 关注的是局部像素变化。失焦常常让边缘变得平缓,因此这类算子可以用来构造模糊筛选的分数;但噪声同样会增加变化,空白背景又可能几乎没有变化。本文先解释分数怎么来,再用同一张合成图做对照,最后讨论怎么把分数用到实际筛选里。
1. 拉普拉斯响应与数据类型
一维二阶差分核通常写为 [1,-2,1];取相反数也是一种符号约定。OpenCV 在 ksize=1 时使用二维四邻域核:
 0   1   0
 1  -4   1
0 1 0它在变化附近产生正、负响应,不能把二阶导数简单说成“像素变化最大的值”。保留浮点响应后,可计算方差或平均绝对值。不要先强制转成 uint8 再统计:大于 255 的数可能发生截断或回绕,负号信息也会丢失,统计量因此改变。八位边缘图适合可视化,不应替代原始响应。
为什么边缘变化能反映模糊
想象一条黑白分界线。清晰时,像素会在很短的距离内从暗变亮;失焦后,这次变化被摊到更宽的过渡带里。把两条亮度曲线画出来,前者陡,后者缓。梯度与二阶差分正是在描述这类局部变化,只是观察角度不同。
拉普拉斯响应的方差衡量这些响应有多分散。一片均匀灰色区域的响应接近零;有文字、细线和纹理的区域,响应的起伏往往更明显。这也解释了它的局限:分数同时看到了“细节数量”和“细节锐利程度”,并不能单独把两者拆开。
例如,一张对焦准确的白墙照片可能低于一张略有失焦的树叶照片。用同一个阈值把白墙删除,很可能是在惩罚画面内容简单。更合适的比较对象,是同一场景连拍、相似主体或同一业务类型的图片。
2. 两种分数与预处理
本文采用拉普拉斯响应的方差与 Sobel 梯度幅值的均值。前者常用于模糊筛选,后者同样可作为清晰度特征;不能说 Sobel 只能检测边缘而不能评估模糊。两种分数的单位、尺度不同,不能直接按倍数判定谁更准确。
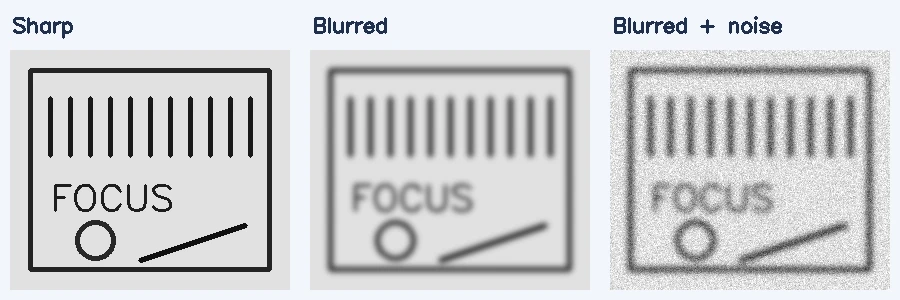
上图把同一图案依次做模糊和加噪处理,方便观察分数受哪些因素影响。示例生成脚本与统计命令见后文。高斯降噪可以减弱噪声影响,也会抹掉真实细节,因此预处理参数必须固定,并重新标定阈值。
先把比较条件统一
原图大小会影响分数。同一张照片缩小后,细节可能消失,缩放插值也会改变局部变化,因此不能一张按原尺寸算,另一张按缩略图算,再拿结果直接排名。下面的实现限制最大边长,并保留纵横比;这提供了一种统一策略,却不意味着所有输入最终都会有完全相同的尺寸。
裁剪区域也同样重要。判断证件照的人脸是否清晰,可以主要看人脸区域;如果整张图一起计算,背景上的文字或头发纹理可能盖过眼部失焦的问题。先明确“想保住哪一部分”,再决定在哪个区域算分数,通常比更换一个复杂公式更有帮助。
3. 可复用的 OpenCV 实现
依赖 opencv-python 与 NumPy。缩放时保持纵横比,限制最大边长;调用者应统一分辨率策略,对不同内容分布分别标定。为避免读图失败后在 cvtColor 中报错,先检查输入。
import cv2
import numpy as np


def preprocess_image(image, max_side=640, denoise_sigma=0.0):
    if image is None or image.size == 0:
        raise ValueError("图像为空或读取失败")
    if max_side < 1 or not np.isfinite(denoise_sigma) or denoise_sigma < 0:
        raise ValueError("尺寸必须为正,降噪参数必须非负")
    h, w = image.shape[:2]
    scale = min(1.0, max_side / max(h, w))
    if scale < 1.0:
        image = cv2.resize(image, (max(1, round(w*scale)), max(1, round(h*scale))),
                           interpolation=cv2.INTER_AREA)
    if image.ndim == 2:
        gray = image
    elif image.ndim == 3 and image.shape[2] == 3:
        gray = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)
    else:
        raise ValueError("本例只接受灰度或 BGR 三通道图像")
    if gray.dtype != np.uint8:
        raise ValueError("本例要求八位输入;浮点与 HDR 图像应另行归一化")
    if denoise_sigma > 0:
        gray = cv2.GaussianBlur(gray, (0, 0), denoise_sigma)
    return gray


def sharpness_scores(gray):
    laplacian = cv2.Laplacian(gray, cv2.CV_64F, ksize=1)
    gx = cv2.Sobel(gray, cv2.CV_64F, 1, 0, ksize=3)
    gy = cv2.Sobel(gray, cv2.CV_64F, 0, 1, ksize=3)
    return {"laplacian_variance": float(laplacian.var()),
            "sobel_mean": float(np.hypot(gx, gy).mean())}


if __name__ == "__main__":
    import sys
    if len(sys.argv) != 2:
        raise SystemExit("用法:python blur_score.py image.jpg")
    image = cv2.imread(sys.argv[1], cv2.IMREAD_COLOR)
print(sharpness_scores(preprocess_image(image)))代码里的预处理与评分分成两个函数,目的是让实验条件显式可见。preprocess_image() 决定尺寸、灰度和降噪;sharpness_scores() 只关心已经准备好的灰度图。调参时一次改变其中一个环节,才知道结果变化来自哪里。
denoise_sigma=0 表示不做降噪,适合先观察原始分数。如果启用了高斯降噪,噪声会变弱,真实的细小纹理也可能被抹去。于是,原先在不降噪条件下选出的阈值就不该直接沿用。预处理不是免费的修正,它本身就是评分方法的一部分。
两个输出也不要合并解释成“准确率”。它们只是同一张图的两种特征:拉普拉斯方差强调二阶变化,Sobel 均值统计梯度幅值。一个分数比另一个大很多,往往只是公式和数值尺度不同,不能据此判断算法更强。
4. 可复现的对照方式
仓库内执行 python3 scripts/generate-blur-samples.py,会用固定种子生成同一图案的清晰、模糊和模糊加噪版本,更新上图,并打印不降噪/统一降噪后的两组分数。代码只处理合成样本,不依赖已失效图床,也不沿用旧版计算方法得到的数值。
实际筛选时,先把分数与人工标注的“可用/不可用”对应起来,再在独立样本上选择阈值与评估误报。最好比较相近内容、相同尺寸和一致预处理的图片:无纹理的清晰天空也可能低分,满是噪声的模糊照片也可能高分。
从分数走到筛选规则
真正要做批量筛选时,可以先抽取一小批实际图片,人为标出“可以接受”和“需要重拍”,再观察两类分数的分布。如果它们大量重叠,说明仅靠这个特征无法完成区分,继续挪动阈值只是把错误从一边移到另一边。
阈值也要对应具体目的。例如,筛掉明显糊掉的照片,可以优先减少误删;要求文字必须可辨认的扫描件,则可能更在意漏掉不合格图片。两者都叫“模糊检测”,却不应共用一套决策标准。
受控样本的作用,是帮助判断变化方向是否符合预期:加模糊后分数怎样,加噪声后又怎样。它不能代替真实照片验证。实际照片还包含压缩、锐化、曝光和运动造成的变化,最终规则要回到真实输入上检查。
5. 优化时保留哪些信息
- 保留原始浮点响应来统计,仅为展示另行转换边缘图。
- 保持裁剪、尺度、边界处理、核大小与降噪参数一致。
- 记录分数使用的具体公式,不把方差与平均绝对值混为同一种指标。
- 若要检测主体清晰度,优先在主体区域计算,避免高纹理背景主导结果。
算子和输出深度可核对 OpenCV 图像梯度教程。本文提供可复现的启发式方法,不声称仅靠一个分数就能覆盖所有图像质量问题。
评论